 夜のAI教室
自分のサイトをAIの学習に使わせない方法|Google・OpenAI・Microsoft・Anthropic共通の「__usage_ai-training」とは?検索には影響する?【2026年11月】
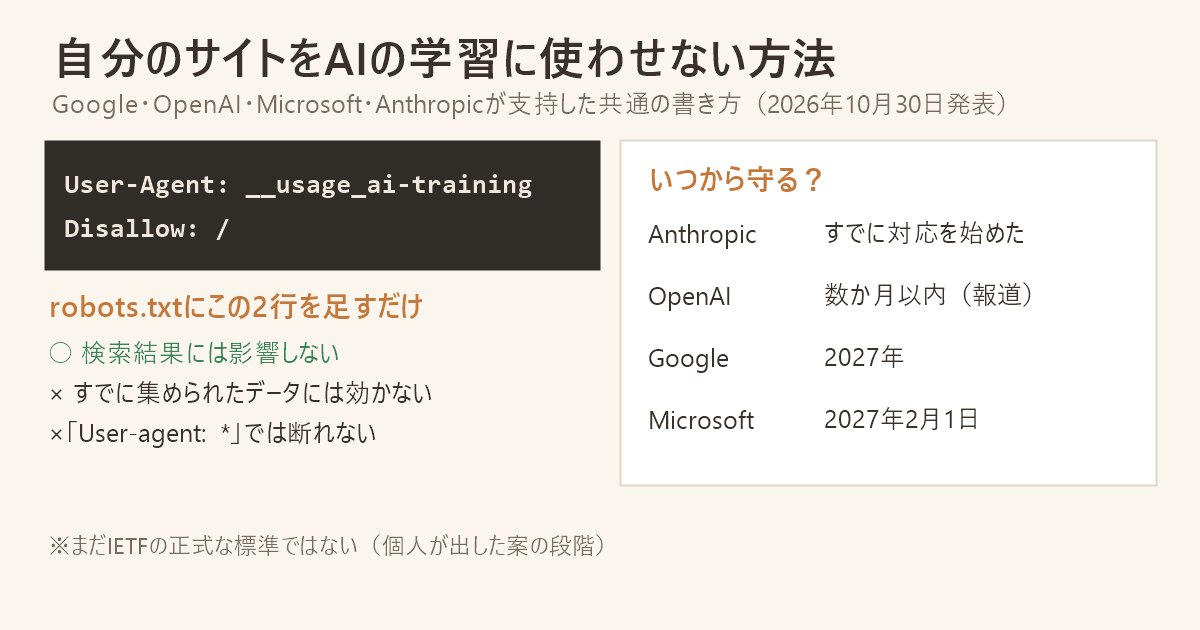
- robots.txtに「User-Agent: __usage_ai-training」と「Disallow: /」の2行を書くと、「このサイトをAIの学習に使わないで」と伝えられます。Google・OpenAI・Microsoft・Anthropicの4社が支持しました
- 対象は「AIの学習」だけで、Google検索やBingの検索結果に載るかどうかには影響しないと、両社の公式ブログに書かれています
- 守り始める時期は会社ごとにちがいます。Anthropicはすでに対応を始め、OpenAIは数か月以内、Googleは2027年、Microsoftは2027年2月1日から。すでに集められたデータには、さかのぼって効きません
ブログやホームページを持っていると、「自分の書いた文章や写真が、勝手にAIの学習に使われているのでは?」と気になることがあると思います。
これまでは、AIの会社ごとに別々の書き方で断る必要がありました。それが2026年10月30日、Google・OpenAI・Microsoft・Anthropicの4社が、共通の書き方を支持すると発表しました。
私もこのブログを持っているので、書き方と注意点を公式の文書で確かめました。
・robots.txtに2行書くだけで「AIの学習に使わないで」と伝えられる
・検索結果に載るかどうかには影響しない(Google・Microsoftの公式ブログ)
・守り始めるのはAnthropic=もう始めた/OpenAI=数か月以内/Google=2027年/Microsoft=2027年2月1日
・すでに集められたデータには効かない。断るなら早めに
robots.txtとは
**robots.txt(ロボッツ・テキスト)**は、サイトのいちばん上の場所に置く小さなファイルです。検索エンジンなどの「ロボット」に、「ここは見ていい」「ここは見ないで」を伝えるために使います。
たとえば、このブログなら https://ai-uradori.com/robots.txt にあります。
書き方:2行足すだけ
新しい目印の名前は「__usage_ai-training」です(最初は「_」が2つ)。サイト全体をAIの学習に使わないでほしいときは、robots.txtに次の2行を足します。
User-Agent: __usage_ai-training
Disallow: /一部だけ学習に使ってもいいときは、Allow: で場所を書き足せます。IETF(インターネットの決まりを話し合う団体)の文書には、こんな例が載っていました。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
(サイト全体は断るけれど、「/press-kit/」の中だけは使ってよい、という意味です)
このブログのrobots.txtは?
私のブログのrobots.txtは、今こうなっています(2026年11月3日に確認)。
User-agent: *
Allow: /

Sitemap: https://ai-uradori.com/sitemap-index.xml
上の注意のとおり、「User-agent: *」は今回の目印には当てはまらないので、このブログは今、AIの学習について何も意思を示していないことになります。
このブログは「AIの使い方」を書いているので、AIに読まれるのはかまわないとも思えます。断るかどうかは、サイトごとに考えて決めるものです。
検索結果には影響する?
影響しないと、各社の公式ブログに書かれています。
- Microsoft(Bing):学習の設定は「Bingの検索結果に出るかどうかは変えない」
- Google:Googleの検索には影響しない(Engadgetの報道)。また、Googleは「この共通の目印で断り、Google-Extendedを特に書いていない場合は、Google-Extendedも断ったものとして扱う」としています
各社はいつから守る?
| 会社 | いつから | 確かめたところ |
|---|---|---|
| Anthropic(Claude) | すでに対応を始めた | IETFのメーリングリスト(2026年10月30日) |
| OpenAI(ChatGPT) | 数か月以内 | 報道(Engadget・Coywolf)。公式記事は開けず |
| Google(Gemini) | 2027年 | Google検索セントラル ブログ(2026年10月30日) |
| Microsoft(Copilot・Bing) | 2027年2月1日 | Bing公式ブログ(2026年10月30日) |
今までの書き方(GPTBotなど)との違い
これまでは、会社ごとのロボットの名前を1つずつ書いて断っていました。
- OpenAI:
GPTBot - Anthropic:
ClaudeBot - Google:
Google-Extended
新しい目印なら、1つのまとまりで、支持する会社すべてに伝えられます。Googleは「会社ごとの書き方も、これまでどおり使える」と書いています。
注意すること
- さかのぼっては効かない。IETFの文書では、そのページを集めたときのrobots.txtの内容が基準になる、とされています。すでに集められたデータは消えません
- 「お願い」であって、強制ではない。守るのは、支持した会社のロボットです
- まだ正式な標準ではない。今の文書は個人が出した案(Anthropicの人が書いたもの)で、IETFの正式な決まりではありません。Googleは「IETFで正式な決まりにしていく」と書いています
ホームページを持っている会社の人へ
工務店やお店のホームページでも、考え方は同じです。
- 施工事例の写真や文章をAIの学習に使われたくない → 2行を足す
- 検索で見つけてもらうことは今までどおり(検索には影響しない)
- 足すのは、ホームページを作った会社か、管理している人に頼めばすぐにできる作業です
まとめ
- robots.txtに「User-Agent: __usage_ai-training」「Disallow: /」の2行で、AIの学習を断れる
- 検索結果には影響しない。ただし、AIの答えの材料に使われることまで止めるものではない
- 守るのは Anthropic=すでに/OpenAI=数か月以内/Google=2027年/Microsoft=2027年2月1日
- すでに集められたデータには効かない。まだ正式な標準ではない